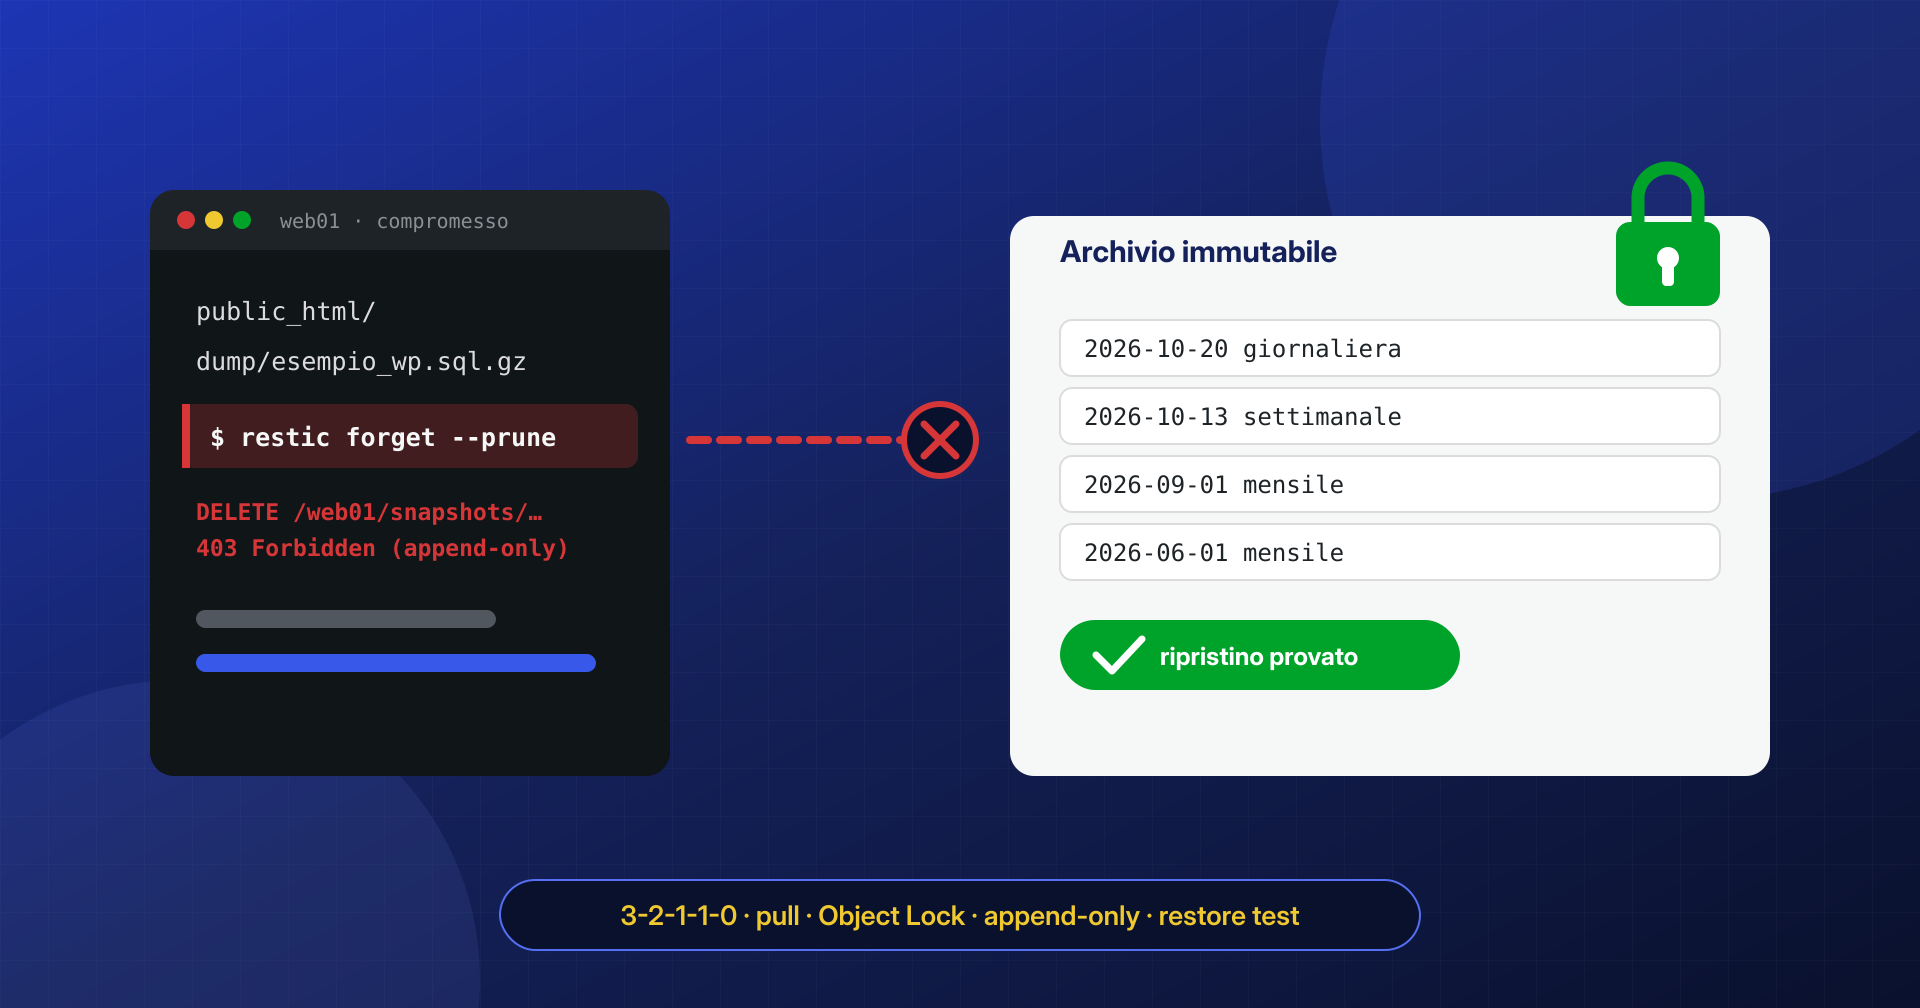
Quasi tutti i siti hanno un backup. Molti meno hanno un backup che sopravvive a un attaccante. La differenza emerge nel momento peggiore: il sito è cifrato o cancellato, si apre il pannello del plugin di backup e le copie non ci sono più, oppure ci sono ma contengono la stessa backdoor che ha causato il disastro, oppure il file del database si interrompe a metà di una tabella. Un backup che non ha mai superato una prova di ripristino è una speranza, non una garanzia.
Un backup è a prova di ransomware quando chi controlla il server del sito non può né cancellarlo né modificarlo, quando risale abbastanza indietro nel tempo da precedere l’infezione e quando qualcuno ha verificato che si ripristina davvero.
In questo articolo vediamo come costruire copie con queste tre proprietà: immutabili, fuori sede e verificate. Non parliamo di come scegliere il backup da cui ripartire dopo un’infezione né dei motivi per cui un ripristino può riportare il malware, che abbiamo trattato nell’articolo sui backup che non bastano a eliminare il malware: qui ci occupiamo di come i backup vanno fatti prima, perché siano ancora lì quando servono.
Perché i backup sono il primo bersaglio
Chi cifra un sito o ne cancella il database per chiedere un riscatto sa che il proprietario, se ha una copia recente, non pagherà. Per questo, quando può, distrugge prima le copie. E su un sito WordPress tipico può quasi sempre, perché i backup stanno in uno di tre posti raggiungibili con gli stessi privilegi con cui ha compromesso il sito.
Il primo è lo stesso server, spesso la stessa cartella: gli archivi in wp-content/backups o in una sottocartella del plugin di backup appartengono all’utente PHP e si cancellano con una riga di codice, quando non sono addirittura scaricabili dal web, come raccontiamo nell’articolo sui file esposti. Il secondo è uno spazio remoto in cui il sito spinge le copie: un FTP, un bucket, un servizio cloud. Le credenziali per scrivere lì sono salvate nel database o in un file di configurazione del sito, quindi chi ha il sito ha anche le chiavi dell’archivio, e se quelle chiavi permettono di scrivere di solito permettono anche di cancellare. Il terzo è un disco dello stesso account di hosting o una snapshot gestita da un pannello a cui si accede con una password riutilizzata.
La regola di progetto che ne deriva è semplice da dire: il sistema che produce i dati non deve avere il potere di distruggere le copie. Tutto il resto dell’articolo è un modo di metterla in pratica.
La regola 3-2-1 e le sue estensioni
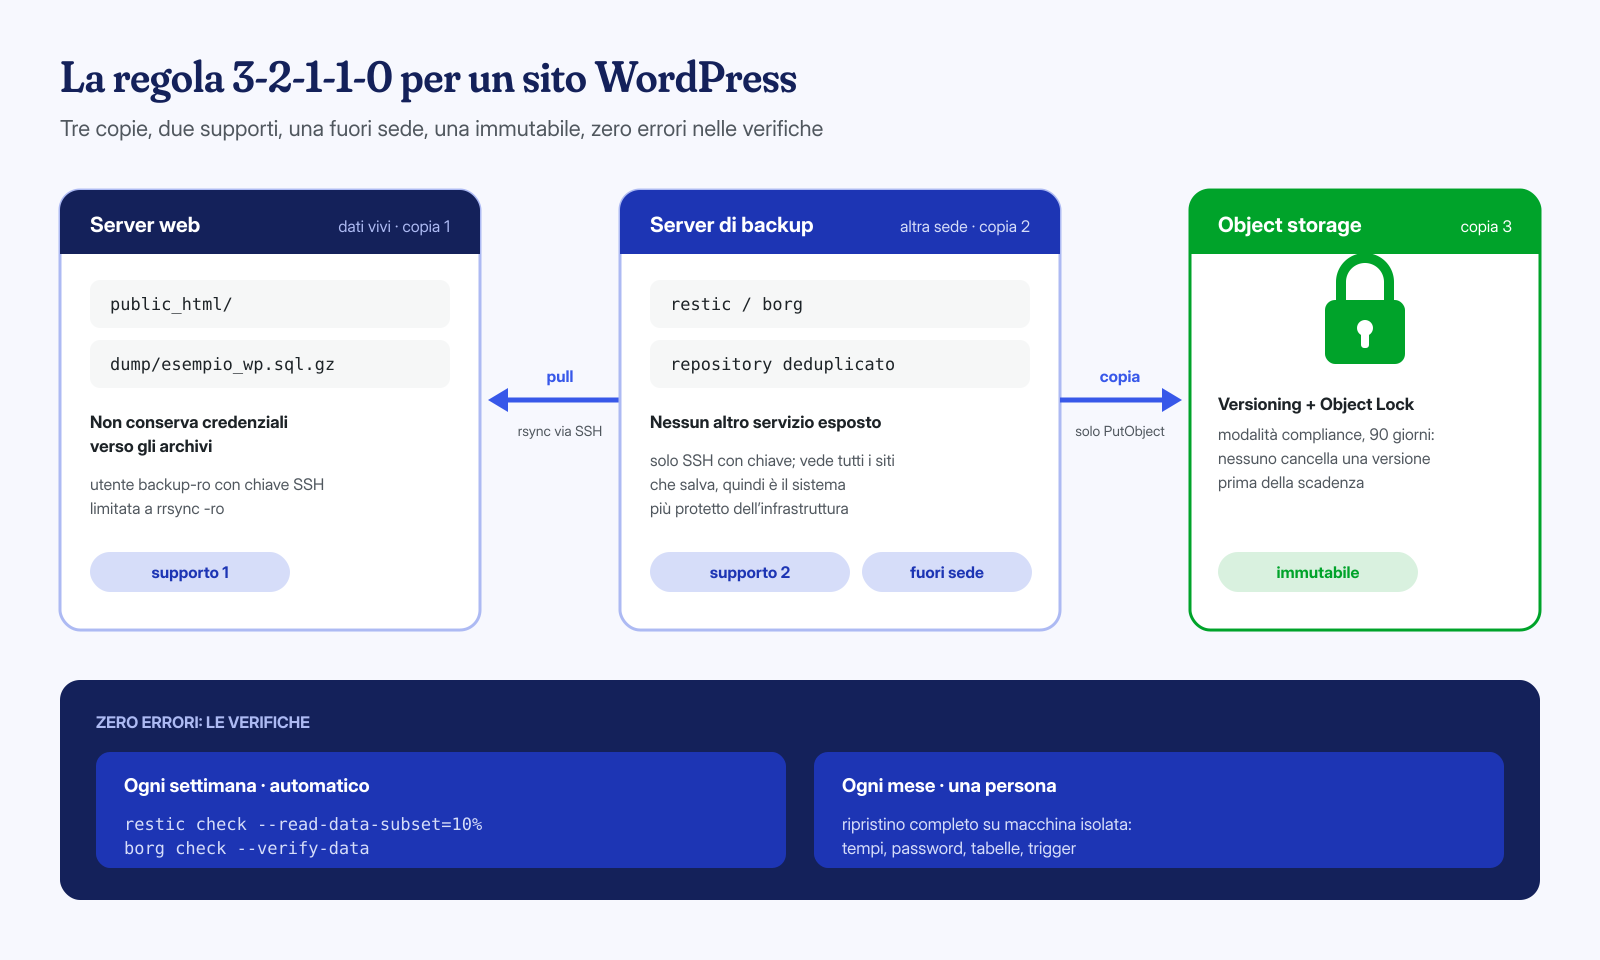
La formula classica è 3-2-1: tre copie dei dati, su due supporti diversi, di cui una fuori sede. È un buon punto di partenza, ma nasce per guasti, incendi e cancellazioni accidentali, non per un avversario che agisce di proposito. Per questo si è diffusa una versione estesa, 3-2-1-1-0, che aggiunge due requisiti: almeno una copia offline o immutabile, cioè non modificabile nemmeno da chi ha credenziali valide, e zero errori nelle verifiche periodiche di ripristino.
Applicata a un sito WordPress su un server Linux, la formula si traduce così: i dati vivi sul server; una copia su un secondo server di backup, in un’altra sede, che la preleva da solo; una copia su object storage con blocco degli oggetti, che nessuno può cancellare prima della scadenza; un controllo automatico che verifica gli archivi e un ripristino di prova fatto da una persona a intervalli regolari. Non serve un’infrastruttura da grande azienda: un piccolo VPS in un altro data center e un bucket con Object Lock bastano per la maggior parte dei siti.
Push o pull: chi possiede le chiavi
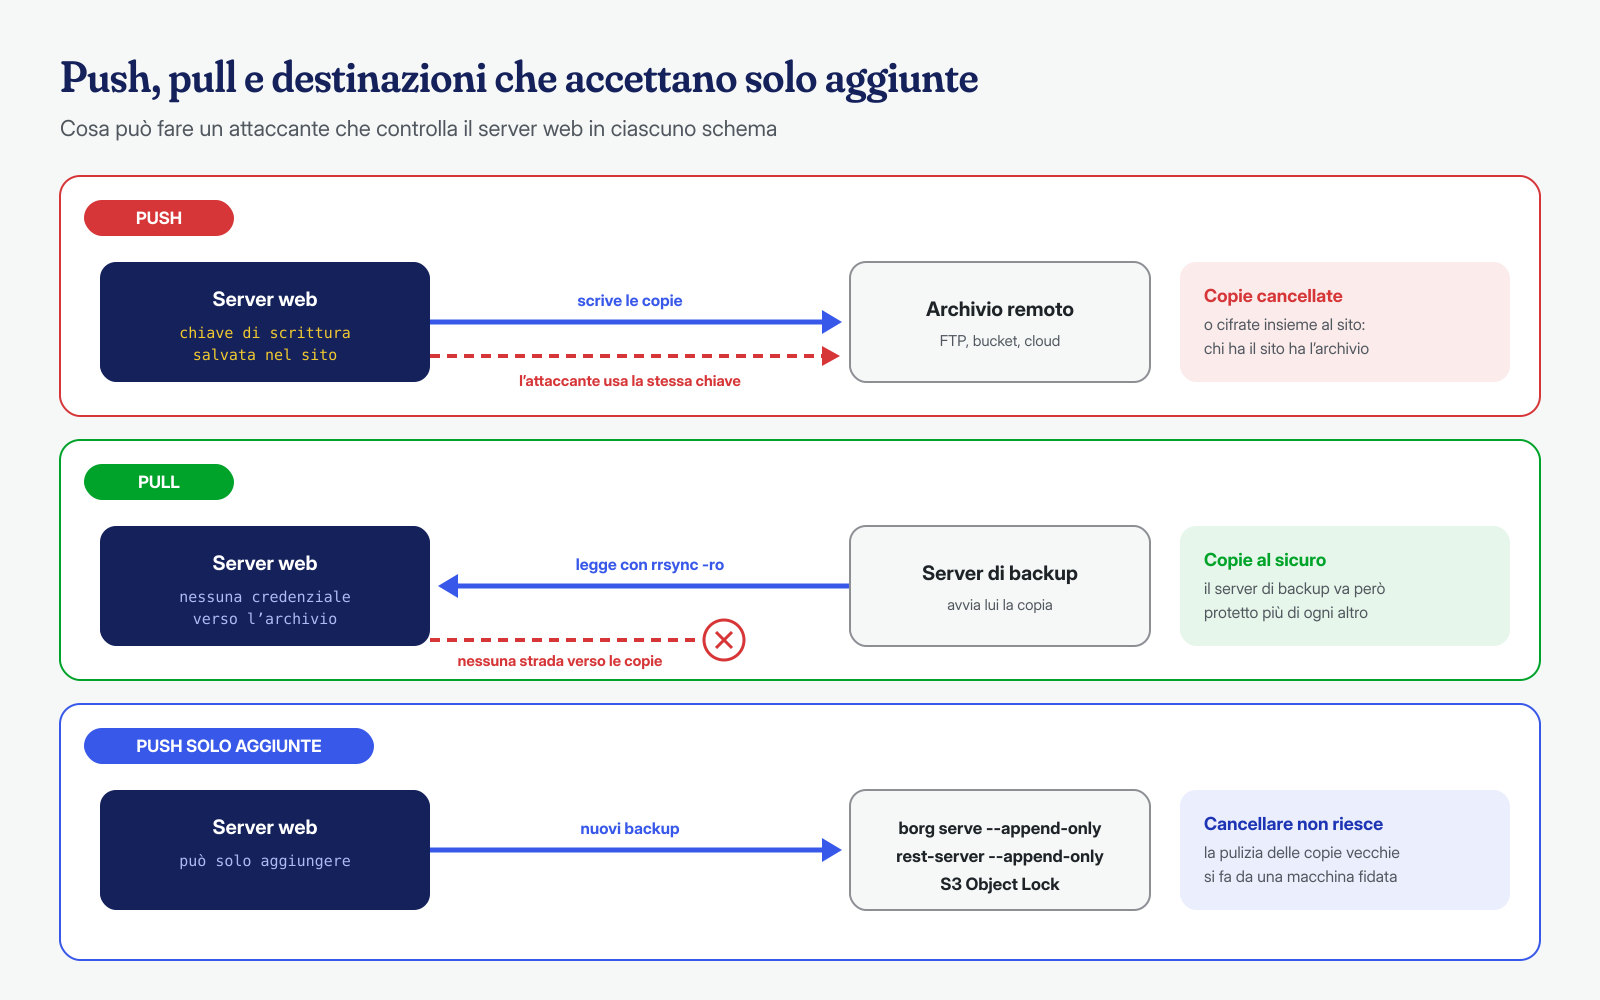
In un backup push è il server del sito che si collega alla destinazione e ci scrive. È lo schema dei plugin di backup e di molti script: comodo, ma il server deve conservare credenziali di scrittura sulla destinazione. In un backup pull è il server di backup che si collega al server del sito, legge i dati e li porta via. Il server del sito non conosce nemmeno l’indirizzo dell’archivio, e se viene compromesso l’attaccante non trova nulla da usare per raggiungerlo.
Il pull si realizza con strumenti standard. Sul server del sito si crea un utente dedicato, con una chiave SSH limitata dal file authorized_keys a un solo comando, rrsync in sola lettura, distribuito insieme a rsync (il percorso cambia da una distribuzione all’altra). Il server di backup lancia la copia a orario:
# Sul server web, in ~backup-ro/.ssh/authorized_keys (una sola riga)
command="/usr/bin/rrsync -ro /var/www/esempio.it",restrict ssh-ed25519 AAAAC3Nz... pull@backup01

# Sul server di backup, da cron: la copia viene prelevata, non spinta
rsync -aH --delete --numeric-ids -e "ssh -i /root/.ssh/pull_web01" \
  backup-ro@web01.esempio.it:/ /srv/staging/esempio.it/
Il pull ha un limite da conoscere: se il server di backup viene compromesso, ha accesso in lettura a tutti i siti che salva. Va quindi trattato come il sistema più protetto dell’infrastruttura: nessun servizio esposto oltre a SSH, accesso solo con chiave, nessun altro compito. Quando il pull non è possibile, per esempio su un hosting condiviso senza SSH, il push resta accettabile a una condizione: che le credenziali salvate sul sito permettano solo di aggiungere dati, e mai di cancellarli. È quello che fanno le due tecniche successive.
Object storage con versioning e Object Lock
L’object storage compatibile con S3 offre un meccanismo di immutabilità vero, applicato dal fornitore e non dal client. Secondo la documentazione di Amazon S3 Object Lock, il blocco segue un modello write once, read many, funziona solo sui bucket con versioning attivo e prevede due modalità. In governance gli utenti con un permesso speciale possono ancora rimuovere il blocco; in compliance nessuno può sovrascrivere o cancellare una versione protetta prima della scadenza, nemmeno l’utente root dell’account, e il periodo non può essere accorciato.
# Bucket con Object Lock (va attivato alla creazione) e ritenzione predefinita di 90 giorni
aws s3api create-bucket --bucket esempio-backup --region eu-south-1 \
  --create-bucket-configuration LocationConstraint=eu-south-1 \
  --object-lock-enabled-for-bucket

aws s3api put-object-lock-configuration --bucket esempio-backup \
  --object-lock-configuration '{"ObjectLockEnabled":"Enabled","Rule":{"DefaultRetention":{"Mode":"COMPLIANCE","Days":90}}}'
Due dettagli fanno la differenza. Il primo: una cancellazione senza numero di versione non fallisce, ma aggiunge un delete marker che nasconde l’oggetto; la versione bloccata resta e si recupera. Chi controlla il bucket dalla console vedrà l’oggetto «sparito» e deve sapere dove cercarlo. Il secondo: le credenziali usate dal server per caricare i backup devono avere solo il permesso di scrittura, senza permessi di cancellazione delle versioni o di aggiramento della governance. La modalità compliance va scelta con consapevolezza, perché anche un errore resta lì fino alla scadenza e si paga lo spazio occupato; per iniziare si può provare la configurazione in governance e passare a compliance quando è stabile.
restic e borg in modalità append-only
I due strumenti di backup deduplicato più usati su Linux hanno entrambi una modalità in cui il client può aggiungere nuovi backup ma non cancellare quelli esistenti. Per borg, la documentazione descrive l’opzione --append-only di borg serve, da imporre sul server di backup nella riga della chiave SSH del client: un client compromesso può aggiungere archivi ma non cancellare definitivamente quelli già scritti. Per restic lo stesso risultato si ottiene con rest-server avviato con --append-only, eventualmente con --private-repos perché ogni utente veda solo il proprio repository.
# borg — sul server di backup, in ~borg/.ssh/authorized_keys (una sola riga)
command="borg serve --append-only --restrict-to-path /srv/borg/web01",restrict ssh-ed25519 AAAAC3Nz... root@web01

# borg — sul server web
borg create --stats ssh://borg@backup01.esempio.it/srv/borg/web01::'{hostname}-{now}' \
  /var/www/esempio.it

# restic — server REST che accetta solo aggiunte
rest-server --path /srv/restic --append-only --private-repos

# restic — sul server web (la password del repository in un file leggibile solo da root)
restic -r rest:https://web01:PASSWORD@backup01.esempio.it:8000/web01/ \
  --password-file /root/.restic-pass backup /var/www/esempio.it
La conseguenza pratica è che la pulizia delle copie vecchie, restic forget --prune o borg prune e borg compact, non si può più fare dal server web: va eseguita da una macchina di amministrazione fidata con un accesso completo al repository. La documentazione di borg segnala un’insidia: un’operazione di scrittura fatta senza append-only, come un prune lanciato da quella macchina, rende definitive anche le cancellazioni tentate in precedenza da un client compromesso. Prima di ogni manutenzione conviene quindi controllare l’elenco degli archivi e cercare buchi o cancellazioni inattese.
Un dump del database coerente e completo
Copiare i file di MySQL mentre il server è acceso produce quasi sempre un backup inutilizzabile. Il database di WordPress va esportato con mysqldump (o mariadb-dump sulle versioni recenti di MariaDB), con le opzioni giuste. Con --single-transaction l’esportazione avviene dentro una transazione e fotografa uno stato coerente delle tabelle InnoDB senza bloccarle, come spiega la documentazione di MySQL; non protegge invece dalle modifiche di struttura fatte durante il dump, per cui aggiornamenti e dump non vanno sovrapposti.
#!/bin/bash
# /usr/local/bin/dump-esempio.sh — credenziali in /root/.my.cnf (chmod 600)
# Il dump sta fuori dalla docroot public_html ma dentro il percorso che viene salvato
set -euo pipefail
DEST=/var/www/esempio.it/dump
umask 027
install -d -m 2750 -g backup-ro "$DEST"   # leggibile solo da root e dal gruppo dell'utente di pull

mysqldump --single-transaction --quick --routines --triggers --events \
  --default-character-set=utf8mb4 --databases esempio_wp \
  | gzip > "$DEST/esempio_wp.sql.gz.tmp"

gzip -t "$DEST/esempio_wp.sql.gz.tmp"
mv "$DEST/esempio_wp.sql.gz.tmp" "$DEST/esempio_wp.sql.gz"
Le opzioni --routines ed --events non sono attive per impostazione predefinita, --triggers sì, ma scriverle tutte rende esplicito che il dump include procedure, eventi e trigger. Serve fedeltà, e serve anche consapevolezza: il malware può vivere proprio lì, come spieghiamo nell’articolo sui trigger SQL malevoli, e un dump completo conserverà anche quelli. Il file temporaneo e il controllo con gzip -t evitano che un dump interrotto sostituisca l’ultimo buono. Lo script gira prima del backup dei file, così che l’archivio contenga sempre la coppia file più database dello stesso momento.
Quanto indietro bisogna poter tornare
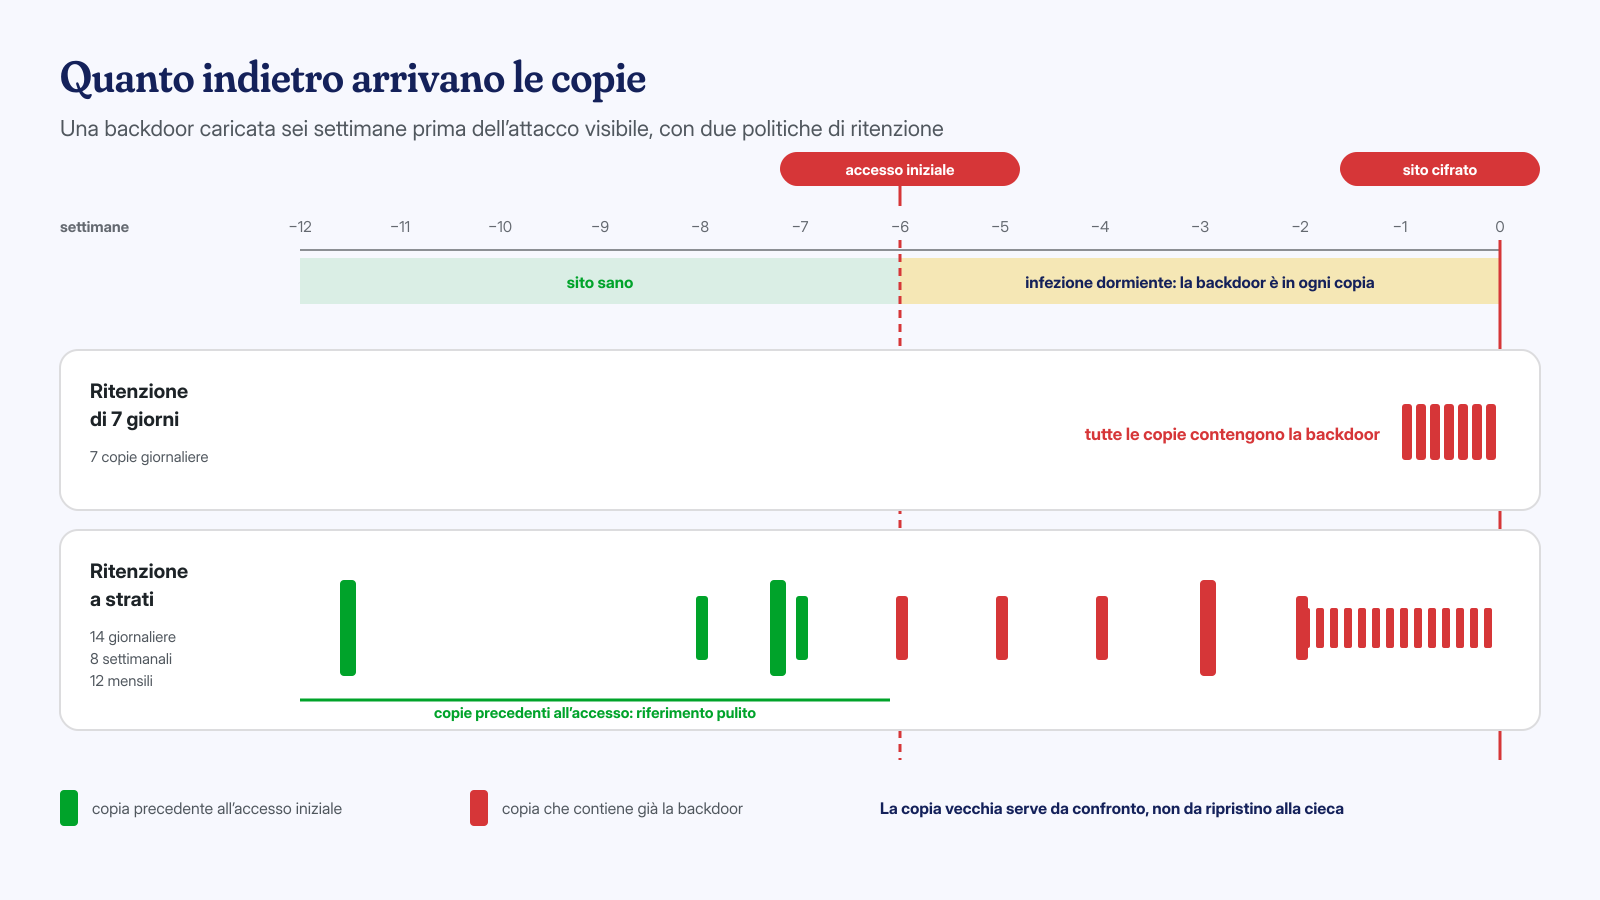
Una ritenzione di sette giorni sembra ragionevole finché non si scopre che la backdoor è stata caricata cinque settimane prima dell’attacco visibile. È lo scenario più frequente: l’accesso iniziale, la fase silenziosa in cui l’attaccante verifica di poter tornare, e solo dopo la cifratura, lo spam o il redirect. Se tutte le copie disponibili sono successive all’accesso iniziale, ogni ripristino riporta la backdoor.
Per questo la ritenzione deve essere a strati: copie giornaliere per le ultime due settimane, settimanali per un paio di mesi, mensili per un anno. Con restic la regola si esprime così, da eseguire sulla macchina di amministrazione:
restic -r rest:https://admin:PASSWORD@backup01.esempio.it:8000/web01/ \
  forget --keep-daily 14 --keep-weekly 8 --keep-monthly 12 --prune
Una copia vecchia non è da ripristinare in blocco: serve come riferimento sano per confrontare i file, recuperare un tema personalizzato prima della modifica, capire quando è comparso un file. La scelta della copia da usare, e perché non va mai ripristinata alla cieca, è l’argomento dell’articolo sui backup e il malware che sopravvive. La ritenzione lunga ha anche un risvolto normativo: le copie contengono dati personali e vanno conservate secondo le regole che ci si è dati, un tema che tocchiamo parlando di GDPR e violazioni.
Verificare: il backup che non si prova non esiste
L’ultimo zero della formula è quello che manca più spesso. Le verifiche sono di due tipi. Il primo è automatico e controlla l’integrità degli archivi: per restic restic check, che con --read-data-subset legge a rotazione una parte dei dati, come descritto nella documentazione di restic, senza scaricare tutto il repository ogni volta; per borg borg check --verify-data. Il secondo è il ripristino di prova, e nessun comando lo sostituisce:
# Ogni settimana: integrità di una parte a rotazione dei dati
restic -r "$REPO" check --read-data-subset=10%

# Ogni mese: ripristino completo su una macchina di prova isolata, mai sul server di produzione
restic -r "$REPO" restore latest --target /srv/prova-ripristino
gunzip -c /srv/prova-ripristino/var/www/esempio.it/dump/esempio_wp.sql.gz | mysql
mysql -e 'SELECT COUNT(*) FROM esempio_wp.wp_posts; SHOW TRIGGERS FROM esempio_wp;'
Il ripristino di prova risponde a domande che nessun controllo automatico può porsi: la password del repository è ancora quella che pensiamo e chi la conosce è ancora in azienda? Il dump contiene tutte le tabelle, comprese quelle dei plugin? Quanto tempo serve davvero a rimettere online il sito? Con il sito ripristinato in un ambiente isolato si misura il tempo, si annotano gli intoppi e si aggiorna la procedura scritta. È anche il momento giusto per controllare che nel ripristino non compaiano trigger, utenti amministratori o file PHP che non si sanno spiegare.
Un backup immutabile non impedisce l’attacco, ma cambia il tipo di incidente: da «abbiamo perso il sito» a «dobbiamo ripristinare, ripulire e chiudere la porta». Su come riconoscere un finto ransomware da uno vero e su cosa fare nelle prime ore trovi un approfondimento nell’articolo su ransomware e defacement su WordPress; per rendere più difficile la modifica dei file sul server, quello sul sito in sola lettura. Se il sito è già compromesso e vuoi capire se i tuoi backup sono utilizzabili, contattaci: bonifichiamo ogni installazione WordPress a livello applicativo e di sistema con tempi garantiti di 6, 12 o 24 ore dalla ricezione degli accessi, e ti indichiamo quale copia può servire da riferimento sano.
