 WordPress
Il contesto
Un’azienda del settore food con un sito WordPress: pagine istituzionali, un catalogo dei prodotti, un blog di ricette aggiornato ogni settimana e un modulo di contatto per i rivenditori. Il sito è ospitato su un server gestito da Managed Server, la società di cui Rimozionemalware.com fa parte, con NGINX davanti a PHP-FPM. Non c’era alcun segno di compromissione: aggiornamenti in regola, nessun file sospetto, nessun avviso dei motori di ricerca. Per riservatezza, il nome dell’azienda, i domini coinvolti e ogni dettaglio che permetterebbe di identificarli sono stati omessi; negli esempi usiamo nomi di fantasia come example.it e copia-uno.example.
Lo diciamo subito: questo non è un caso di rimozione malware. Il sito non era infetto, e l’intervento è stato gestito come supporto di hosting e sicurezza. Lo raccontiamo perché il problema, un sito clonato in tempo reale su domini altrui, è sempre più frequente, e perché la soluzione più intuitiva era quella sbagliata.
La richiesta del cliente
Una mattina il responsabile marketing dell’azienda ha chiamato il supporto. Un rivenditore gli aveva segnalato un indirizzo strano, e cercando in rete ne aveva trovati altri: in tutto tre domini sconosciuti. Due avevano lo stesso nome del marchio con un’estensione diversa, .info e .pro; il terzo non aveva alcun legame apparente con l’azienda. Aperti nel browser, mostravano il sito dell’azienda, identico in tutto: menu, fotografie, schede prodotto, perfino la ricetta pubblicata quella stessa mattina. Passando il mouse sui link, però, nessuno portava al sito vero: tutti puntavano al dominio sconosciuto. La richiesta era chiara: «bloccateli via referral».
La preoccupazione era fondata. Una copia fedele di un sito, su un dominio che ne richiama il marchio, è uno strumento pronto per molti usi: basta aggiungere un modulo o cambiare un indirizzo email per trasformarla in una pagina di phishing o in un finto negozio che incassa ordini mai spediti, come descritto nell’articolo sui kit di phishing. Anche senza modifiche, i cloni sottraggono visite e mettono in circolazione contenuti duplicati: le norme antispam di Google descrivono lo scraping come la pratica di prendere contenuti da altri siti, spesso in modo automatico, e ripubblicarli per manipolare il posizionamento. E se qualcuno viene truffato su una copia, il danno di reputazione ricade sul marchio originale.
Perché il blocco per referral non bastava
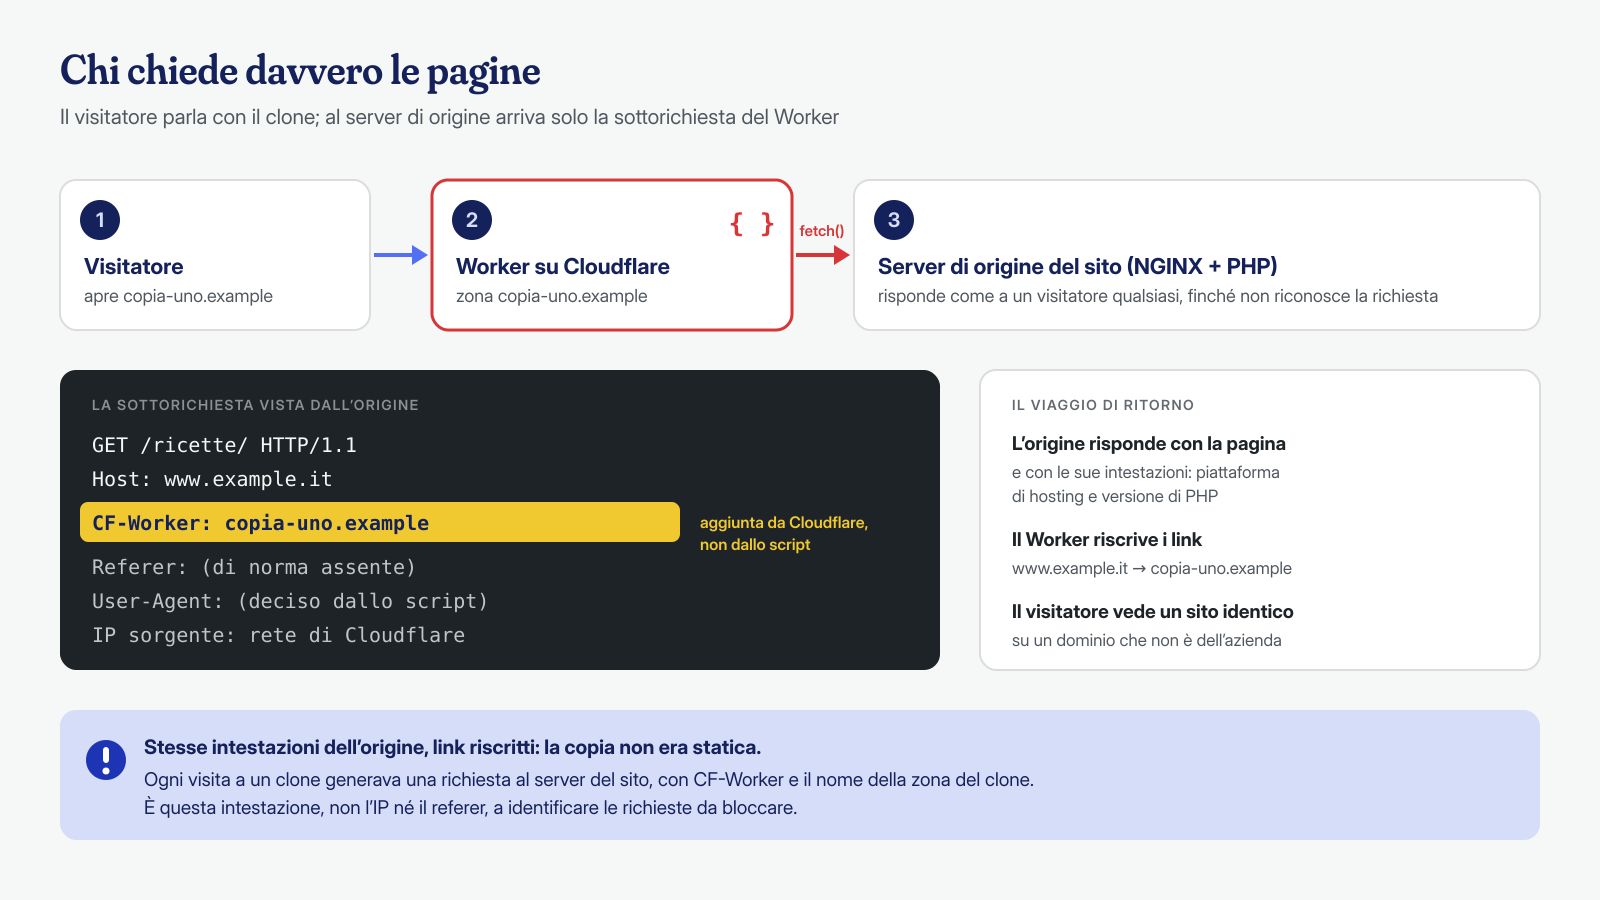
Il referer è un’intestazione che il browser aggiunge quando un visitatore segue un link o quando una pagina carica un’immagine o un foglio di stile: dice al server da quale pagina arriva la richiesta. Bloccare per referer funziona bene contro chi incorpora le immagini di un sito nelle proprie pagine. Qui però il contenuto appariva sul dominio sconosciuto già completo e con i link riscritti, e questo fa pensare a un meccanismo diverso: un proxy inverso, cioè un server che riceve la richiesta del visitatore, scarica la pagina dal sito originale per conto suo, la modifica e la restituisce.
In quello schema la richiesta che arriva al sito originale non parte dal browser del visitatore, ma dal server del clone, che di norma non invia alcun referer, o invia quello che preferisce. Un blocco per referer non l’avrebbe fermato. Prima di scrivere una regola bisognava quindi trovare qualcosa che identificasse davvero quelle richieste, e per farlo bisognava capire come venivano fatte.
L’indagine
La prima domanda era semplice: copia statica o copia in tempo reale? Una copia statica, scaricata una volta e pubblicata altrove, non si può bloccare dal server originale: si può solo segnalare. Una copia in tempo reale, invece, deve passare dal nostro server a ogni visita. Abbiamo chiesto le intestazioni di risposta dei tre domini:
# Intestazioni di risposta di un clone (nomi di fantasia)
curl -sI https://copia-uno.example/ | grep -iE '^(server|x-powered-by|x-)'
La risposta è stata eloquente. Tutti e tre i cloni restituivano l’intestazione che la nostra piattaforma di hosting aggiunge alle risposte dei siti ospitati e la stessa intestazione con la versione di PHP del sito originale. Una copia statica su un altro server avrebbe avuto le intestazioni di quel server. Insieme ai link riscritti, era la prova che le pagine venivano prelevate in diretta dal server di origine e modificate al volo.
Il passo successivo erano i log di accesso, per vedere da dove arrivassero quelle richieste. Qui abbiamo commesso un errore, e lo raccontiamo perché è istruttivo: sul server il sito aveva anche un secondo virtual host, usato per il backup, e per primi abbiamo aperto i log di quello. Non c’era nulla di utile, e per qualche minuto l’ipotesi del proxy è sembrata vacillare. Poi ci siamo accorti di guardare il file sbagliato e siamo passati ai log del virtual host principale, dove le richieste c’erano, in corrispondenza esatta delle nostre visite ai cloni. È il genere di svista che le analisi dei log di accesso insegnano a evitare: prima di trarre conclusioni, verificare di leggere il log giusto.
Le richieste arrivavano da indirizzi IP di Cloudflare, cioè dagli intervalli pubblicati dalla stessa Cloudflare e condivisi da un numero enorme di siti. Bloccarli avrebbe significato bloccare traffico legittimo, e comunque gli indirizzi cambiano: non era una strada praticabile. L’ipotesi più concreta era un Cloudflare Worker, un piccolo programma che gira sulla rete di Cloudflare e che, a ogni visita al dominio del clone, scarica la pagina corrispondente dal sito originale, ne riscrive i link e la restituisce al visitatore.
Per confermarla abbiamo attivato un log diagnostico temporaneo, che registrava alcune intestazioni delle richieste, e visitato i cloni:
# Log diagnostico temporaneo (nel contesto http)
log_format diag_intestazioni '$remote_addr [$time_local] "$request" '
                             'cf_worker="$http_cf_worker" referer="$http_referer" '
                             'ua="$http_user_agent"';

# Nel blocco server del sito, solo per il tempo della verifica
access_log /var/log/nginx/example.it-diag.log diag_intestazioni;
Il risultato non lasciava dubbi: ogni richiesta proveniente dai cloni portava l’intestazione CF-Worker, con il nome del dominio del clone. La documentazione di Cloudflare sulle intestazioni HTTP spiega che CF-Worker viene aggiunta a tutte le sottorichieste che un Worker invia con fetch() e contiene il nome della zona, cioè del dominio, che possiede il Worker. È un dettaglio importante: l’intestazione la aggiunge la piattaforma di Cloudflare, non lo script di chi ha creato il clone. Non è una garanzia assoluta per il futuro, ma è un segnale molto più affidabile di un referer o di uno User-Agent, che lo script può impostare a piacere.
Il blocco
A quel punto il criterio era chiaro: rifiutare le richieste che portano un’intestazione CF-Worker diversa dalla zona del sito stesso. L’eccezione per la propria zona non è un dettaglio: se un domani il sito passasse a Cloudflare e usasse dei Worker propri, le loro sottorichieste porterebbero il nome del dominio del sito e non devono essere bloccate.
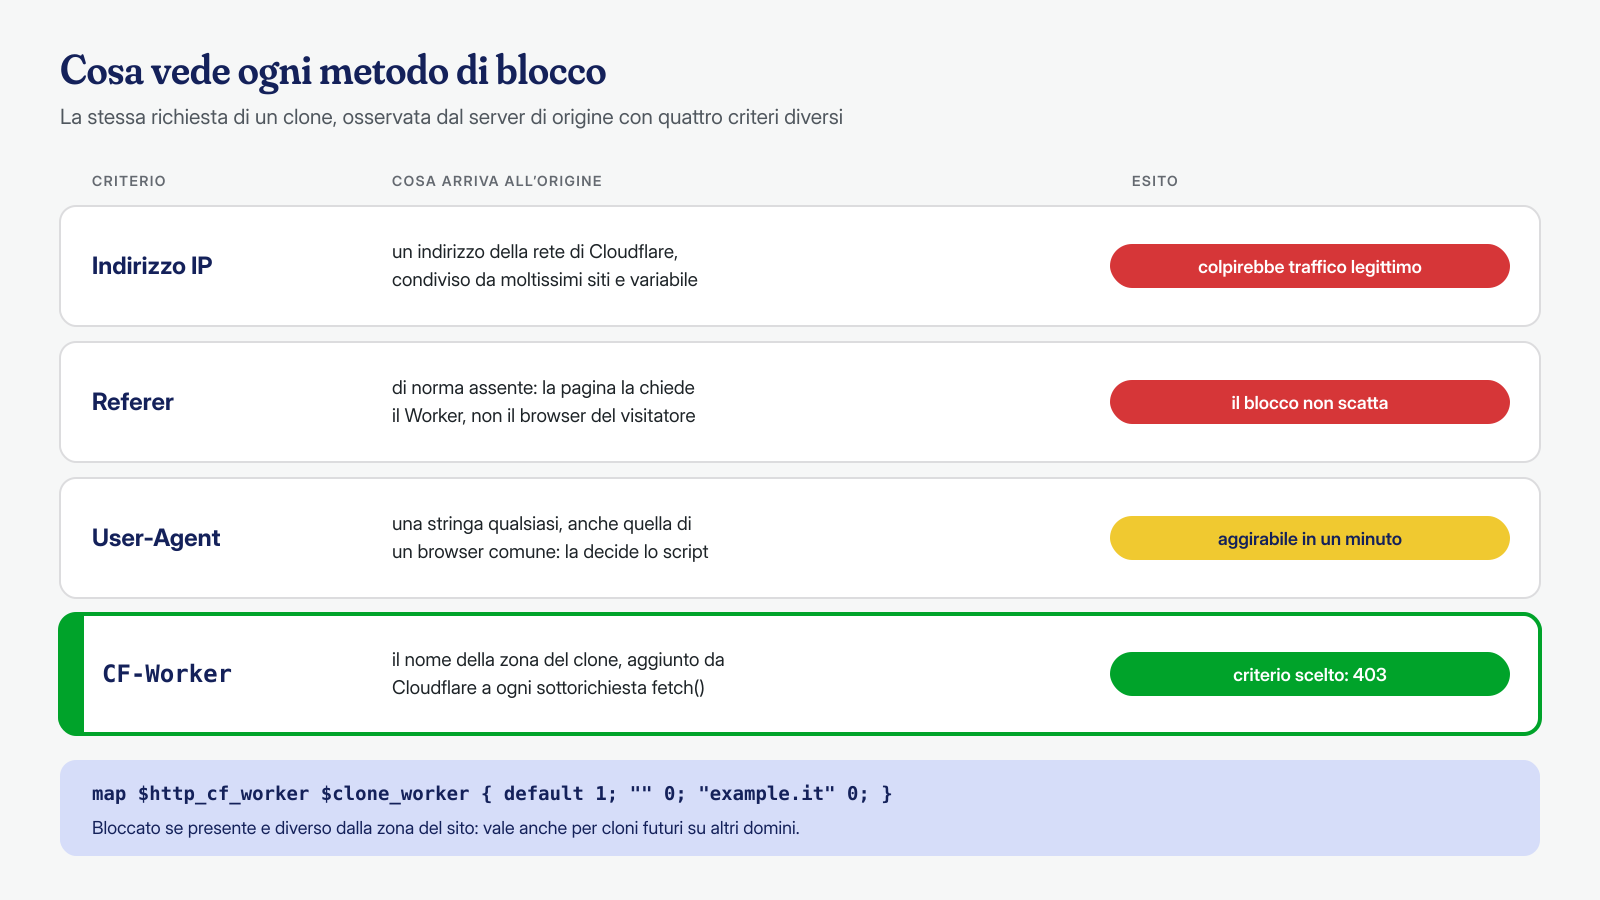
Prima di toccare qualsiasi cosa abbiamo salvato una copia del virtual host. Poi abbiamo creato un nuovo file di configurazione, incluso nel contesto http di NGINX, con due direttive map. La prima legge l’intestazione tramite la variabile $http_cf_worker: come spiega la documentazione di NGINX, ogni intestazione della richiesta è disponibile come $http_ seguito dal nome in minuscolo con i trattini sostituiti da trattini bassi. La seconda, di rinforzo, controlla il referer dei tre domini, per le eventuali risorse che il browser di un visitatore richiedesse direttamente al sito originale partendo da una pagina clonata.
# /etc/nginx/conf.d/blocco-cloni.conf (contesto http)

# 1 se la richiesta arriva da un Cloudflare Worker di un'altra zona
map $http_cf_worker $clone_worker {
    default      1;   # CF-Worker presente e di una zona estranea
    ""           0;   # nessuna intestazione CF-Worker
    "example.it" 0;   # Worker della zona del sito stesso
}

# Rinforzo: 1 se il referer è uno dei domini clone noti
map $http_referer $clone_referer {
    default 0;
    "~*^https?://([^/]+\.)?copia-uno\.example(/|$)"  1;
    "~*^https?://([^/]+\.)?copia-due\.example(/|$)"  1;
    "~*^https?://([^/]+\.)?copia-tre\.example(/|$)"  1;
}
Nel blocco server HTTPS del sito sono bastate due righe. Con la direttiva if una variabile vale falso quando è vuota o vale 0, quindi le richieste normali passano senza alcun costo:
server {
    listen 443 ssl;
    server_name example.it www.example.it;
    # ...

    if ($clone_worker)  { return 403; }
    if ($clone_referer) { return 403; }

    # ... resto della configurazione
}
Infine la sequenza di sempre: nginx -t per verificare la sintassi, ricaricamento del servizio senza interrompere le connessioni e rimozione del log diagnostico, che non serviva più e non doveva restare attivo.
La verifica
Abbiamo controllato ogni dominio, sia sulle pagine sia su un foglio di stile, e il sito vero con e senza www:
# Codice di risposta per ogni indirizzo
for u in https://copia-uno.example/ https://copia-uno.example/wp-content/themes/tema/style.css \
         https://copia-due.example/ https://copia-due.example/wp-content/themes/tema/style.css \
         https://copia-tre.example/ https://copia-tre.example/wp-content/themes/tema/style.css \
         https://www.example.it/ https://example.it/; do
  printf '%-70s %s\n' "$u" "$(curl -s -o /dev/null -w '%{http_code}' "$u")"
done

# Dominio             Pagine   CSS
# copia-uno.example   403      403
# copia-due.example   403      403
# copia-tre.example   403      403
# www.example.it      200      200
# example.it          200      200
I tre cloni rispondevano 403 su pagine e fogli di stile, il sito vero rispondeva normalmente. C’è anche un effetto collaterale utile: la regola su CF-Worker non dipende dai nomi dei tre domini. Se domani qualcuno costruisse un nuovo clone con lo stesso sistema su un quarto dominio, sarebbe bloccato senza modificare la configurazione. La mappa dei referer, invece, copre solo i domini noti ed è solo un rinforzo.
Il blocco ferma la copia, ma i domini restano registrati e i Worker attivi. Abbiamo quindi consigliato al cliente di segnalarli al servizio abusi di Cloudflare, così che vengano sospesi alla fonte, e ci siamo offerti di preparare e inviare noi la segnalazione. L’intera vicenda, dalla telefonata alla verifica, si è chiusa in giornata.
L’hardening
Il sito non era stato violato, ma l’episodio ha suggerito alcune misure, utili anche su qualsiasi altro sito:
- meno informazioni nelle intestazioni: le versioni del software non devono uscire dal server. In NGINX
server_tokens offtoglie la versione dall’intestazioneServere dalle pagine di errore; in PHPexpose_php = Offelimina l’intestazioneX-Powered-Bycon la versione. In questo caso le intestazioni ci hanno aiutato a capire, ma a un attaccante dicono esattamente quali vulnerabilità cercare; - tag canonical assoluti su tutte le pagine, verso il dominio vero. Google li considera un segnale forte, non un ordine, e un clone che riscrive i link può riscrivere anche quelli: aiutano con le copie grossolane, non sostituiscono il blocco;
- sorveglianza dei domini simili: i certificati pubblicamente riconosciuti finiscono nei registri di Certificate Transparency, consultabili con servizi come crt.sh. Una ricerca periodica sul nome del marchio mostra i nuovi domini che lo usano, spesso prima che qualcuno li segnali.;
- controlli regolari su chi raggiunge l’origine: un sito che non usa Cloudflare non dovrebbe ricevere sottorichieste di Worker, e una verifica periodica dei log alla ricerca di
CF-Worker, di proxy o di picchi da reti di hosting fa emergere nuovi cloni prima che lo faccia un rivenditore.
Sul piano dei rapporti con i fornitori, il titolare ha più strade. Cloudflare dichiara che, quando è il fornitore che ospita il contenuto, come nel caso dei Worker, può rimuoverlo o disabilitarne l’accesso se viola i suoi termini di servizio. I registrar accreditati presso ICANN sono tenuti a pubblicare un contatto per le segnalazioni di abuso e a esaminarle. Per i domini che riprendono il marchio esistono anche procedure di contestazione dei nomi a dominio, che vanno valutate con un legale: non sono una questione tecnica, e non è il nostro campo.
Cosa insegna questo caso
La prima lezione è che un blocco va costruito su ciò che identifica davvero la richiesta, non su ciò che è più facile da scrivere. Il referer era la soluzione intuitiva, l’indirizzo IP quella più drastica: la prima non avrebbe fermato nulla, la seconda avrebbe bloccato una parte di internet. La soluzione giusta è arrivata solo dopo aver capito il meccanismo, osservando le richieste reali invece di supporle.
La seconda riguarda il metodo. Controllare prima le intestazioni dei cloni, poi i log, poi le singole intestazioni delle richieste ha trasformato un’ipotesi in una prova in poco tempo. E l’errore del virtual host di backup ricorda che anche un’indagine breve ha bisogno di una verifica elementare: essere sicuri di guardare il sistema giusto prima di escludere un’ipotesi. Lo stesso approccio lo usiamo nelle bonifiche, dove una conclusione sbagliata costa molto di più.
Rimozionemalware.com è il servizio di bonifica dei siti WordPress e WooCommerce di Managed Server S.r.l., attiva dal 2005 nella gestione di server e hosting. Analizziamo file, database, configurazione e sistema, con l’aiuto di modelli di intelligenza artificiale eseguiti in locale, e garantiamo la pulizia entro 6, 12 o 24 ore per installazione, calcolate dalla ricezione degli accessi. Se il tuo sito compare su domini che non conosci, o sospetti che qualcosa non vada, puoi contattarci.